こんにちは、データ分析チームのやっすーです。
前回「新卒1年目のエンジニア成長記」を執筆してから、1年ほどが経ちました。
当時の私は、アプリケーションエンジニアから、キャリアプランとして目指していたデータサイエンティストにジョブチェンジした直後でした。
データサイエンティストになってからは、レコメンドロジックの改善や分析レポートの作成、エージェント開発など日々新しいことに取り組んでいます。
そして、職種以外にもこの1年で開発環境が大きく変わりました。
社内ではClaude Code(以下、Claudeと表記します)の活用が活発になり、Claude活用の知見共有や、新たなSkillの開発などが日々行われています。
私もタスク起票からリリースまで一気通貫でClaudeを活用しており、作業に欠かせない存在になっています。
今回は、そんなClaudeを自社のレコメンドロジックの改善サイクルに組み込んでみた話を書いていきます。
データ分析チームのロジック改善とは
本題に入る前に、軽くAppDriverについて紹介させてください。
AppDriverは、アプリやポイントメディアに広告面を提供する、成果報酬型のリワード広告プラットフォームです。
メディア内の広告面には、多数の広告案件が並んでいます。
ユーザーは案件のアプリをインストールしたり、ゲーム内のミッションを達成したりすると、メディア内ポイントを受け取れるようになっています。
広告面のイメージや、より詳しい情報については、以下の公式サイトをご覧いただけると幸いです。
このAppDriverには、広告案件の表示順をユーザーごとに最適化するレコメンド基盤があります。
レコメンド基盤では、ユーザーに見せる案件の順番をロジックで制御しており、ロジックの中では案件ごとに計算したスコアを用いて表示順を決めています。
このロジックを改善して売り上げを伸ばすのが、データ分析チームの仕事のひとつとなっています。
ロジック改善は次のサイクルで回しています。
- ロジック発案:ユーザー行動に関する仮説を立てる
- 予備分析:仮説がデータ上で成り立つかをBigQueryで確かめる
- ロジック実装:仮説をロジックに落とし込んでリリースする
- 検証:新ロジックをABテストで走らせて、ログが貯まるのを待つ
- 効果検証:目標KPIへの影響を分析する
今回はこのサイクルのほぼ全工程にClaudeを組み込んで、ロジック改善を回してみました。
ロジック発案から効果検証までの1サイクルにかかった期間は、およそ1ヶ月でした。
内訳としては、ロジック発案に2日、予備分析に3日、ロジック実装に1週間、検証に2週間、効果検証に2日となっています。
ただし、検証の2週間はユーザーの行動データが貯まるのを待つ工程なので、実働は2週間強でした。
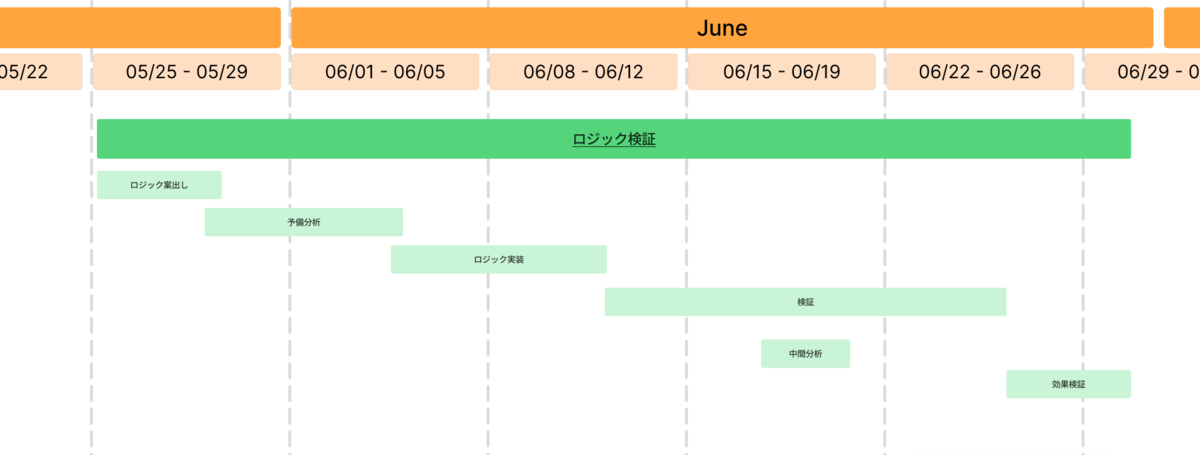
ここからは各工程でClaudeをどう使ったのか、順番にお話ししていきます。
また、先にお断りしておくと、改善ロジックの内容やデータの詳細については割愛させていただきます。
ロジック発案
ロジック発案は、レコメンドロジックの改善アイデアを出して、検証に進める仮説を固める工程です。
今回はまず、BigQueryのスキーマとレコメンド基盤のコードをClaudeに読み込ませて、改善案を出してもらいました。
このとき、データやコードなどのコンテキストとともに要件を2つ渡しています。
1つ目の要件は基盤のアーキテクチャ制約です。
スコアリングのような重い計算をリアルタイムで実施すると、レスポンスタイムが伸びてユーザーに不便な思いをさせてしまいます。
そのため基盤には、重い計算はバックグラウンドの1日1回のバッチで実行し、リアルタイム処理はデータストアのキー引きだけで完結させるという設計原則があります。
この原則を、案出しの前提として渡しました。
この要件がないと、リクエストのたびにリアルタイムでスコアを集計するような、重〜いシステムが作成されてしまいます。
2つ目の要件は改善案の記載フォーマットです。
次の4つの項目を案ごとに書いてもらうように形式を指定しました。
- 仮説
- 実装コスト(5段階評価)
- 売上向上効果(5段階評価)
- 開発方針
この形式で記載することで案ごとの実装コストや効果を比較できるので、改善案の採否を判断しやすくなります。
しかし、コンテキストやデータ、要件などを渡しても、Claudeが出してくる改善案はけっこう大雑把で、ビジネス上あり得ない案も混ざっていることがあります。
印象に残っているのは、認証率(ユーザーの成果を認める割合)を100%にするとユーザーの意欲が湧く、という仮説です。
要は「不正な成果だったとしても、ユーザーの行動意欲のために認証しましょうね!」という内容です。
当然採用できるわけない
Claudeはデータやコードなどのコンテキストは読めても、「広告の成果として何を認めてはいけないか」という暗黙の制約までは読めません。
そのため結局は、改善案の発案はClaudeに任せて、中身の確認は人の目で行う形に収まりました。
それでも、案出しの壁打ちに使う価値は十分ありました。
自分の認識にはなかった面白い案から堅実な案まで素早く出してくれるので、発案工程の工数を大きく削減できました。
案の質を期待するのではなく、案を並べる速さを活かした壁打ち台として使うのが、今のところの正解かなと思っています。
予備分析
予備分析は、立てた仮説が本当に成り立つのかを、実装前にデータを用いて確かめる工程です。
そして、全工程の中でClaudeが一番効果があったのはこの工程でした。
仮説の予備分析では、知りたい情報に合わせてスキーマを調べてクエリを作成し、実行結果を眺めて次のクエリを考える、という往復を繰り返します。
これを人の手で行うと1往復ごとに数十分程度かかり、確かめたい情報量によっては数十往復、場合によっては数百往復も回すことになります。
そこで、BigQueryのMCPを繋いでいるClaudeの出番です。
これによってClaudeが自分でBigQueryにクエリを投げられるようになります。
ただし、BigQueryと繋いだだけで良い分析をしてくれるわけではありません。
効果的な分析を実施するためには先にコンテキストを持たせる必要があります。
次の2点のコンテキストをClaudeに渡して分析を進めました。
- 主要テーブルのスキーマと各カラムの意味を、参照できるドキュメントとして渡しておく
- データ分析の観点(どの指標で判断するか、除外すべきデータは何か、集計期間をどう取るか)を指示に含める
このコンテキストを明確にして渡しておかないと、Claudeはカラム名の字面から意味を推測してクエリを書くので、もっともらしく間違った集計が返ってくる可能性があります。
実際、一部のテーブルにはレガシーなカラムが残っていて、現在は使われていないものも存在します。
こういう現場の暗黙知で詰まらないようにコンテキストを事前に渡しています。
そして、ここまで準備すれば、その後の予備分析の作業は簡単です。
「このデータを知りたい」とClaudeに伝えると、スキーマの確認→クエリ作成→クエリ実行→結果要約の手順で、欲しい情報を返してくれます。
これにより、予備分析の往復を高速に回せました。
そうして固まった仮説と検証計画は、MVPキャンバスという形に整理します。
MVPキャンバスの記述項目は次のとおりです。
| 項目 | 記入内容 |
|---|---|
| 仮説 | 検証したい仮説を一文でまとめる |
| 背景 | 仮説の根拠となるデータや予備分析の結果をまとめる |
| 検証方法 | 仮説をどのように確かめるかを決める |
| 作るもの | 検証に必要な実装の範囲を洗い出す |
| KPI | 成否を判断する指標を定める |
| リスク | 想定される悪影響や懸念点を挙げる |
MVPキャンバスを作成することでステークホルダーとの認識を揃えやすくなり、成否を測る基準も実装前に固定化できます。
また、ここまで情報を揃えてドキュメント化しておくと、ロジック実装以降の工程で判断がブレなくなります。
このように実施内容が固まったら、次にロジック実装へと移ります。
ロジック実装
ロジック実装は、MVPキャンバスで整理した仮説や作るものをベースに、実際にコードを開発する工程です。
実装におけるClaudeの活用方法についてはすでに多くの記事で紹介されているので、ここでは要点だけに絞ります。
今回実施したのは、「スコアを集計するパイプラインの構築」と「レコメンド基盤へのロジック追加」の2点です。
これらは過去に数回のロジック検証を経ていて、細部を除きファイル構成やメソッドがパターン化されています。
そのため、既存ロジックの実装と手順ドキュメントをClaudeに読み込ませると、インターフェースからテストまで既存のパターンに倣って開発してくれます。
一方で、設計判断はClaudeに任せず、私が実施しました。
集計結果をどういう単位で持つかは、既存データとの互換や運用コストに響くため、Claudeの提案を鵜呑みにはできませんでした。
実装自体はClaudeで効率化して、意思決定部分を人が見る、という形が落とし所としては良いかなと思います。
検証
検証は、リリースした新ロジックをABテストで走らせて、効果検証に必要なデータが貯まるのを待つ工程です。
待つ工程といっても、新ロジックによって売り上げなどの数値が大幅に悪化することも起こり得るため、検証期間の途中に、数値確認という形で中間分析を実施します。
中間分析では、レコメンド基盤に用意されているレポートで各ロジックの数値を確認します。
数値が大幅に悪化している場合はその時点で検証をストップします。
とはいえ大幅な悪化はまれなので、ほとんどの場合はそのまま検証を続行します。
また、検証期間の待ち時間を活用して次のロジック改善サイクルを回すこともあります。
この待ち時間にロジック発案からロジック実装までを進めておくと、スムーズに次のロジック改善を実施できます。
従来の人の手だけで進めるとかなり厳しいスケジュールですが、Claudeを最大限活用して実働を効率化することで、並行してサイクルを回せます。
効果検証
効果検証は、貯まったデータから仮説が正しかったかを確認する工程です。
今回はロジック検証期間を2週間と定めており、その2週間分のデータを使って効果を算出します。
この工程でももちろんClaudeを活用しています。
やることは基本的に予備分析と同じで、検証期間で収集したデータをもとに仮説が正しいかを分析します。
また、効果分析では数値の算出だけでなく、Pythonのグラフ描画ツールを使った可視化も行っています。
これらの作業はClaudeがクエリ作成からPythonコードの作成までを担うため、効果検証を非常に速く進められました。
効果検証の結果、媒体全体では売り上げ・eCPMともにわずかな数値改善が見られました。
さらにロジック対象の案件群に絞ると、売り上げ・eCPMともにはっきりとした改善が確認できました。
ちなみにeCPMは、広告の表示1,000回あたりの売り上げで、広告面がどれだけ効率よく収益を生んでいるかを表す指標です。
また、媒体全体とロジック対象で数値改善の差が大きいのは、改善範囲を絞り込んでいるからです。
今回はPoCも兼ねてロジックの適用範囲を狭めているため、媒体全体への影響は大きくありません。
それでも数値改善が確認できたので、適用範囲を広げて再度検証するという結論になりました。
ロジック改善業務では、このように仮説の検証だけで終わらせず、効果検証で次回のアクションを決めて次の改善サイクルに活かすところまで行っています。
今回の検証では媒体全体で見ると大きな数値改善には至りませんでしたが、こうした細かな改善を地道に積み重ねて、最終的に目標KPIの達成に繋げています。
さいごに
ロジック発案から効果検証まで、およそ1ヶ月でロジック改善サイクルを回しました。
ロジック改善でどれだけClaudeを活用できるかは、序盤のMVPキャンバス作成までのコンテキストをどこまで精密にできるかが鍵になっていると思います。
MVPキャンバスが整理されていれば、後続の工程はそれを参照してタスクを実行するだけなので、サイクルを速く回せます。
一方で、改善案の採否やデータの持ち方といった意思決定は、これからも人が担うべき部分だと感じています。
また、ロジック改善中に学んだ知見やSkillは次のサイクルでも活用できるため、今後もロジック改善のスピードは上がっていくはずです。
Claudeに任せる部分と人が判断する部分をうまく分担しながら、これからもロジック改善サイクルを速く回し続けていきたいと思います。
AIエージェントをロジック改善に活用してみたい方にとって、本記事が少しでも参考になれば幸いです!
