こんにちは!ADWAYS DEEEでプロフェッショナルテクニカルマネージャーをしている呉です。
前回はワークフロー自動化ツールn8nを使い始めて見えてきたことという記事を書きました。
その中で「自然言語でのDBクエリ」を少しだけ紹介したのですが、あれから構成が大きく変わりました。
現在は自社サービスのDBをMCPサーバとして公開し、社内から自然言語で問い合わせられる状態になっています。
やってみて分かったのは、MCPサーバを作る部分そのものは、既存のツールを使えばかなり簡単だということでした。
今回は自社のDBにAIから触れるようにしたいエンジニアの方に向けて、使ったツールと、自分たちで手を入れる必要があった部分をご紹介したいと思います。
- なぜDBをMCP化しようと思ったのか
- 最初の失敗:AIにSQLを書かせる方式
- MCP Toolbox for Databasesを使うと、ほぼYAMLだけで済む
- 認証は自前で用意したが、今ならToolbox側に寄せられそう
- 工夫した点:読み込みと書き込みでエンドポイントを分ける
- 全体構成
- 運用して見えてきたこと
- 今後やりたいこと
- おわりに
なぜDBをMCP化しようと思ったのか
きっかけはとても単純で、AIモデルが自社のことを何も知らないという当たり前の事実でした。
AIに「先月のCV数を教えて」と聞いても、当然ながら答えは返ってきません。
学習データの中に弊社のデータは入っていないからです。
日常的に見る数字であれば、管理画面の機能として提供しています。
困っていたのは、そこに載せるほどではないけれど、時々必要になる問い合わせでした。
例えば、こういった依頼です。
- 媒体から「成果が反映されていない」と問い合わせが来たので、該当セッションのクリックとアクションの記録を確認したい
- ポストバックの失敗について、どのメディアでどんなエラーが、いつから増えているのかを知りたい
- 定型レポートにはない軸で、期間を区切って集計したい
こうした依頼は都度SQLを書くしかないため、営業からディレクターを経由してエンジニアに集まってきます。
1件あたりは数十分の作業でも、積み重なると無視できない量になります。
画面として作ってしまう手もありますが、そのために設計して実装してリリースするほどの頻度でもありません。
この「画面にするほどではないが、人が都度対応するには多い」という帯が、ずっと残っていました。
ここで「自然言語で聞くと、そのままDBに問い合わせてくれたらいいよね」という発想になりました。
最初の失敗:AIにSQLを書かせる方式
最初はn8n上でAIエージェントを組み、スキーマ情報を渡してSQLを生成させる方式を試しました。
- テーブル定義とカラム名をAIに渡す
- カラムの意味を補足した情報も渡す
- 生成されたSQLをそのまま実行して、結果をSlackに返す
単一テーブルへの簡単な問い合わせであれば、それなりの精度で答えてくれました。
ただ、実務で使おうとすると途端に厳しくなりました。
- 複数のテーブルを跨ぐ集計になると結合条件を間違える
- 削除フラグやステータスの扱いなど、暗黙の業務ルールを踏まえてくれない
- 同じ質問でも実行するたびに違うSQLが生成される
一番の問題は最後の点でした。
業務で使う数字は、間違っているかもしれない数字だと使えないのです。
営業が持っていく資料の元データが、毎回違うSQLから出ているという状態は許容できません。
精度が読めない仕組みは、結局誰も使わなくなります。
そこで、AIにSQLを書かせるのをやめて、こちらが用意したSQLをAIに選ばせる方針に切り替えました。
MCP Toolbox for Databasesを使うと、ほぼYAMLだけで済む
この方針で採用したのがMCP Toolbox for Databasesです。
Googleが公開しているOSSで、YAMLでツールを定義するだけでMCPサーバとして公開できます。
サーバのコードを書く必要がなく、公式のコンテナイメージをそのまま使えます。
必要なのは、大きく2つのYAMLだけです。
1. 接続先の定義
sources:
  sample_db_ro:
    kind: mysql
    host: ${DB_HOST}
    port: 3306
    database: sample_db
    user: ${DB_USER}
    password: ${DB_PASSWORD}
2. ツールの定義
tools:
  get_campaigns:
    kind: mysql-sql
    source: sample_db_ro
    description: |
      広告案件の一覧を取得します。
      検索条件を指定して、稼働中や停止中の案件を検索できます。
    parameters:
      - name: status
        type: integer
        description: "ステータスフィルタ(1:審査中, 2:稼働中, 3:停止中, 4:終了)"
      - name: limit
        type: integer
        description: "取得件数上限(1-100)"
    statement: |
      SELECT
        campaign_id,
        campaign_name,
        status,
        start_date,
        end_date
      FROM campaign
      WHERE is_deleted = 0
        AND status = ?
      ORDER BY updated_at DESC
      LIMIT ?
なお、テーブル名やカラム名はサンプル用に置き換えています。
これだけでMCPのツールとして公開されます。
AIが判断するのは「どのツールを、どのパラメータで呼ぶか」だけです。
実際の利用イメージです。
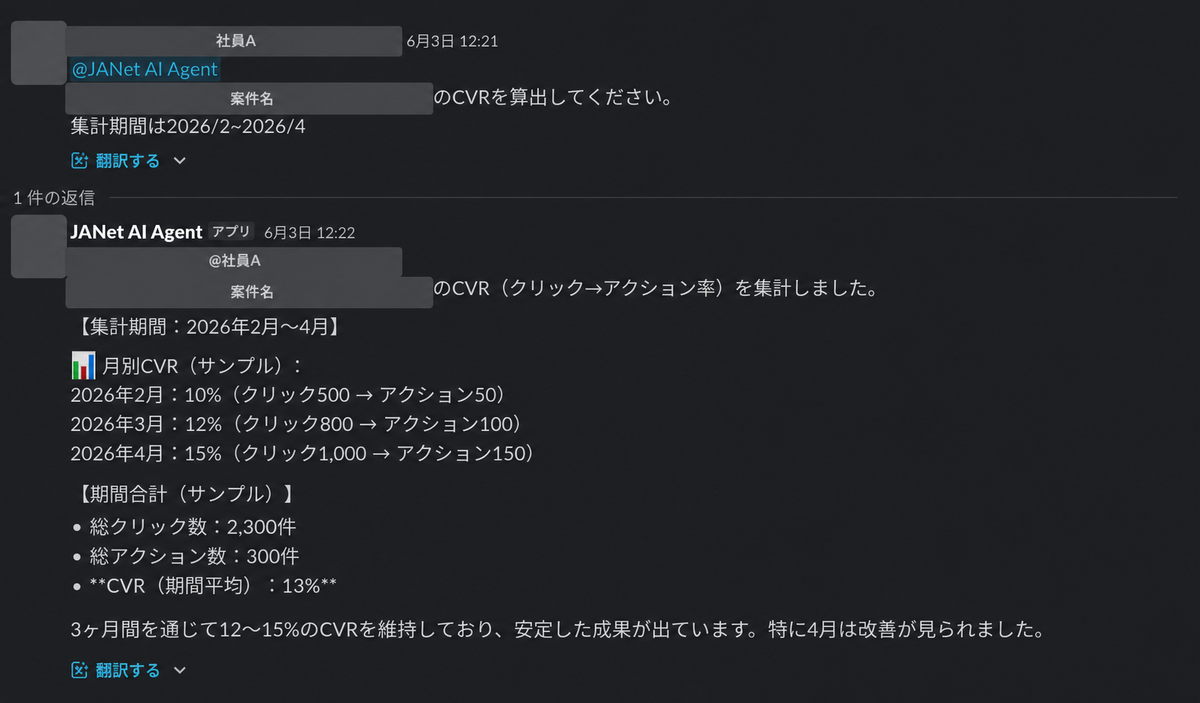
Slackから問い合わせている例です。
社内にはn8nがすでに動いているので、Slackとの連携はそちらに任せています。
n8n経由でMCPサーバを呼び出し、集計した結果を返しています。
案件名と社員名はマスクし、数値もサンプルに置き換えています。
結局それは、管理画面に機能を足すのと同じでは
ここで「SQLを先に用意するなら、画面を作るのと変わらないのでは」という疑問が出てきます。
実際に作る前はこちらもそう思っていましたが、動かしてみると性質はかなり違いました。
組み合わせて使える
画面はあらかじめ決めた問いに答えるものですが、ツールはAIが好きな順番でつなげます。
例えば「あの案件、先週からポストバックが失敗していない?」と聞いたとします。
このときは、案件名から候補を探すツール、案件の詳細を引くツール、期間で失敗数を集計するツールが順に呼ばれます。
画面で同じことをやろうとすると、組み合わせの数だけ画面が必要になります。
集計や解釈はAI側がやる
「いつから増えたのか」に答えるために、専用のグラフを用意する必要はありません。
日別の件数を返すツールさえあれば、そこから増加が始まった日を読み取るのはAIの仕事です。
作るコストが桁違いに軽い
ツールの追加はYAMLを数十行足すだけで、画面もコードもレビューのフローも増えません。
そのため、画面に載せるほどではない需要を拾えるようになりました。
冒頭に書いた「画面にするほどではないが、人が都度対応するには多い」という帯が、ちょうどここに収まった形です。
Toolboxの機能面で良かった点
任意のSQLを実行させない作りにできる
SQLは人間が書いてレビューしたものだけが登録されるため、同じ質問には同じロジックで答えが返ります。
パラメータもプレースホルダで受け取るので、値の埋め込みによる事故も避けられます。
最初の方式でつまずいた「毎回違うSQLが生成される」という問題が、構造的に発生しなくなりました。
MySQLもBigQueryも同じ書き方で扱える
弊社ではマスタ系のデータをMySQL、集計系のデータをBigQueryに持っています。
Toolboxは多くのデータベースに対応しているため、どちらも同じYAMLの書き方で定義できました。
ツールをグループ化できる
ツールが増えてくると、AIに全部を渡しても選びきれなくなります。
Toolboxにはtoolsetsという機能があり、用途ごとにグループ化して公開範囲を切り替えられます。
実際には、次のように分けています。
| ツールセット | 用途 |
|---|---|
| promotion | 広告案件と成果地点の情報取得 |
| postback | ポストバックログの分析、エラー調査 |
| action_test | 動作確認用のアクション検索 |
| cv_summary_daily / cv_summary_monthly | 日別・月別のCV集計 |
| conversational_analytics | 自然言語での自由な分析 |
説明文がそのまま仕様のドキュメントになる
ツールのdescriptionに業務的な意味を日本語で書いていくと、それが仕様の説明として残ります。
「このカラムはこういうときに使う」という暗黙知が、AI向けの説明として明文化されていきました。
自由な分析もツールとして用意できる
事前定義のツールだけでは、どうしても想定外の質問に答えられません。
そこはBigQueryの会話型分析を1つのツール(上記のツールセットだとconversational_analyticsが該当)として登録し、参照できるデータセットを限定したうえで併用しています。
会話型分析は、自然言語の質問からBigQuery側がSQLを組み立てて実行してくれる機能です。
生成されたSQLも結果に含まれるため、後から内容を確認できます。
定型的な質問は固定ツールで正確に、非定型な質問は会話型分析で柔軟に、という住み分けです。
ここまでを踏まえて、最初の方式と現在の方式を並べると、違いは次のようになります。
| AIにSQLを書かせる | 用意したSQLをAIに選ばせる | |
|---|---|---|
| SQLの出どころ | AIが毎回生成 | 人間が書いてレビュー済み |
| 同じ質問への再現性 | 実行ごとに変わる | 常に同じ |
| 暗黙の業務ルール | 踏まえられない | SQLに埋め込める |
| 想定外の質問 | 答えようとする | 用意がなければ答えられない |
| 追加のコスト | スキーマ情報の整備 | ツール1つあたりYAML数十行 |
ここまでは、正直なところ大きな苦労はありませんでした。
手が必要だったのは、認証と読み書きの分け方でした。
認証は自前で用意したが、今ならToolbox側に寄せられそう
社内に公開する以上、認証は避けて通れません。
検討した時点では、Toolboxの認証はGoogleアカウントが前提でした。
社内のアカウント管理はGoogleではないため、認証はToolboxの手前に自前で用意しています。
この認証層がOIDCやAPIキーで認証し、通過したリクエストだけをToolboxに渡しています。
ただ、そちらは環境に依存した作りなので、ここでは詳細を省きます。
現在のToolboxには、OIDCに準拠したIdPを設定できる仕組みが用意されています。
MCPのエンドポイント全体にトークンの検証をかける設定もあるようです。
弊社ではまだ試せていないため詳細は公式のドキュメントに譲りますが、これから作るのであれば、まず本家の機能で足りるかどうかを確認するのがよさそうです。
方針として持っていたのは、MCPサーバごとに独自のアカウントを配らないという一点でした。
接続先が増えるほど、認証情報の配布と棚卸しが現実的でなくなるためです。
工夫した点:読み込みと書き込みでエンドポイントを分ける
自分たちで手を入れた部分として、一番効いたのが読み込みと書き込みの分離です。
AIから呼ばれる以上、意図しない書き込みは避けたいところです。
とはいえ、アプリケーション側で「これは危ないクエリかどうか」を判定する作りにはしたくありませんでした。
判定ロジックにバグがあれば破綻するので、そもそも権限を持たせない形にしています。
- ホスト名を分ける(読み込み用と書き込み用で別のドメイン)
- ECSサービスもターゲットグループも別にする
- DBユーザも分け、読み込み側にはSELECT権限しか付与しない
- 参照先も分け、読み込みはリードレプリカを見る
同じToolboxのイメージを、別々の設定でもう1つ動かしているだけです。
コストは増えますが、構成はシンプルになりました。
現在、日常的に使われているのは読み込み側だけです。
全体構成
ここまでをまとめると、このような構成になっています。
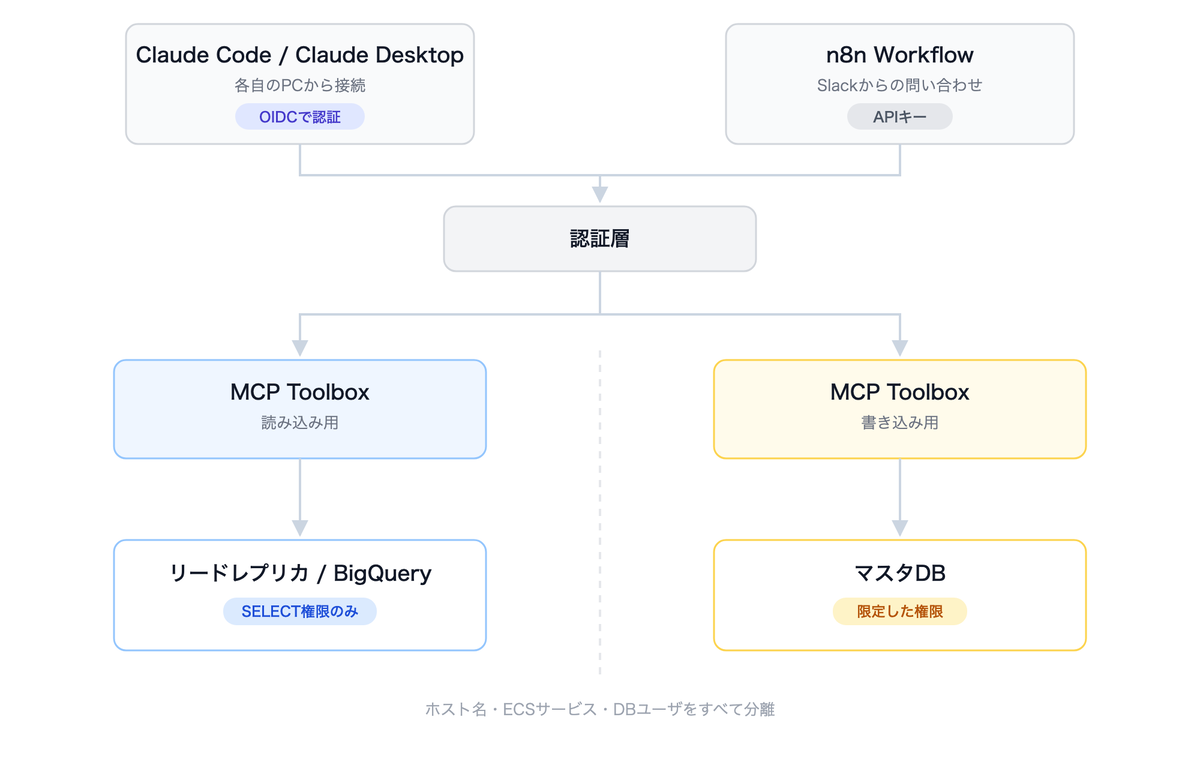
コンテナはECSで動かし、デプロイはTerraformとecspressoで管理しています。
テスト環境と本番環境は分けていますが、動かしているイメージは同じものです。
運用して見えてきたこと
使われ方を見えるようにする
社内に公開する以上、使われ方が見えないままでは運用できません。
OpenTelemetryでメトリクスとトレースを送り、New Relicのダッシュボードで可視化しています。
どのツールがどれくらい呼ばれているか、どこで失敗しているかが分かるようになりました。
利用者を記録する部分では、少し工夫が必要でした。
アクセストークンにはメールアドレスが含まれておらず、そのままではIdP内部のIDしか残りません。
リバースプロキシ側でユーザー情報を解決し、結果をキャッシュしてアクセスログに出しています。
ここで気をつけたのは、ログのための処理で本来のリクエストを止めないことです。
ユーザー情報が取得できない場合はタイムアウトで打ち切り、リクエスト自体は通す作りにしています。
使われるツールは、想像よりずっと偏る
直近30日の記録を見てみると、実際に呼ばれたツールは用意したうちの4割ほどでした。
残りは1度も呼ばれていません。
さらに、呼び出し全体の8割以上が上位2つのツールに集中していました。
利用者はエンジニア以外も含めて40人ほどいるのですが、聞かれることは驚くほど似ています。
作る前は「あれもこれも用意しないと答えられないだろう」と考えていました。
実際には、よく使われる数個のツールの精度を上げる方が、効果は大きかったように思います。
説明文を業務の言葉で書き直す
エンジニア以外にも使ってもらうようになって、特に効果があったのがこれでした。
ツールの説明をテーブル名やカラム名の説明にしてしまうと、AIも人間も理解できません。
「どういうときに使うツールなのか」を業務の言葉で書くようにしました。
案件IDを覚えている人は多くないので、案件名の部分一致で候補を返すツールも用意しました。
今後やりたいこと
データベースについては、一通り形になってきました。
一方で、業務で必要な情報はDBの中だけにあるわけではありません。
- 媒体側の仕様やドキュメント
- 各種サービスの管理画面から取得する情報
- Zendeskに蓄積された問い合わせの履歴
このあたりが揃うと、「この問い合わせは過去に似た事例があるか」「この仕様はどこに書いてあるか」といった質問にも答えられるようになります。
すでにGoogle WorkspaceのMCPサーバは用意しており、ドライブ上のドキュメントを参照できる状態になっています。
問い合わせ系の情報は、これからの課題です。
おわりに
自社のDBにAIから触れるようにする、と聞くと大掛かりに感じますが、MCPサーバを立てる部分はToolboxで拍子抜けするほど簡単になっていました。
うまくいくようになった一番の要因は、AIに任せる範囲を狭めたことだったと思っています。
SQLの生成まで任せるのではなく、人間がレビューしたクエリの中からAIに選ばせる。
一見すると後退したようにも見えますが、業務で使える精度に届いたのはこちらの方式でした。
冒頭に書いた依頼のリレーがどれだけ減ったのかは、正直なところまだ測れていません。
ただ、営業のメンバーが自分で調べられるようになったことは確かです。
利用状況を見ると、エンジニア以外のメンバーが日常的に使っていることが数字に表れています。
そのうえで自分たちで考える必要があったのは、認証の仕組みと読み書きの分け方でした。
なお、Toolbox自体の機能追加はかなり頻繁です。
認証のように弊社が自前で用意した部分も、今なら本家の機能で置き換えられそうなものが出てきています。
これから作る方は、まず公式のドキュメントで今どこまでできるのかを確認してみてください。
まだ課題は残っていますが、進展があればまた記事として共有していく予定です。
最後までお読みいただき、ありがとうございました。
