はじめに
こんにちは!広告事業本部でアプリケーションエンジニアをしている25新卒の佐々木です!
以前、「資格なんて意味ない」を覆した、新卒1年目でAWS SAPまで取得してチャンスを掴み取った話 という記事を書きました。AWS SAPを取得したことで、「EC2からECSへのサービス移行」を任せてもらえたという内容です。インフラ未経験の新卒が、サービスの根幹に関わるタスクを任されました。
※ AWS SAPとは、AWS Certified Solutions Architect – Professionalの略称です。AWSにおける設計や運用の知識を問う、プロフェッショナルレベルの認定資格です。
あれから約4か月、2026年7月にECSへの移行が無事完了しました!
実際に手を動かしてみると、資格の勉強で得た知識に助けられる場面がたくさんありました。その一方で、資格の知識だけでは全く歯が立たない場面もありました。
そこでこの記事では、EC2からECSへの移行で実際にやったことを紹介しつつ、資格で得た知識が「効いた場所」と「効かなかった場所」を正直に書いていきます。
「AWSの資格を取ろうか迷っている」「資格が実務でどう役立つのか知りたい」という方や、「サービスのインフラをモダナイズしたい」という方に読んでいただけたら嬉しいです。
EC2 から ECS へ移行した背景
移行前の構成
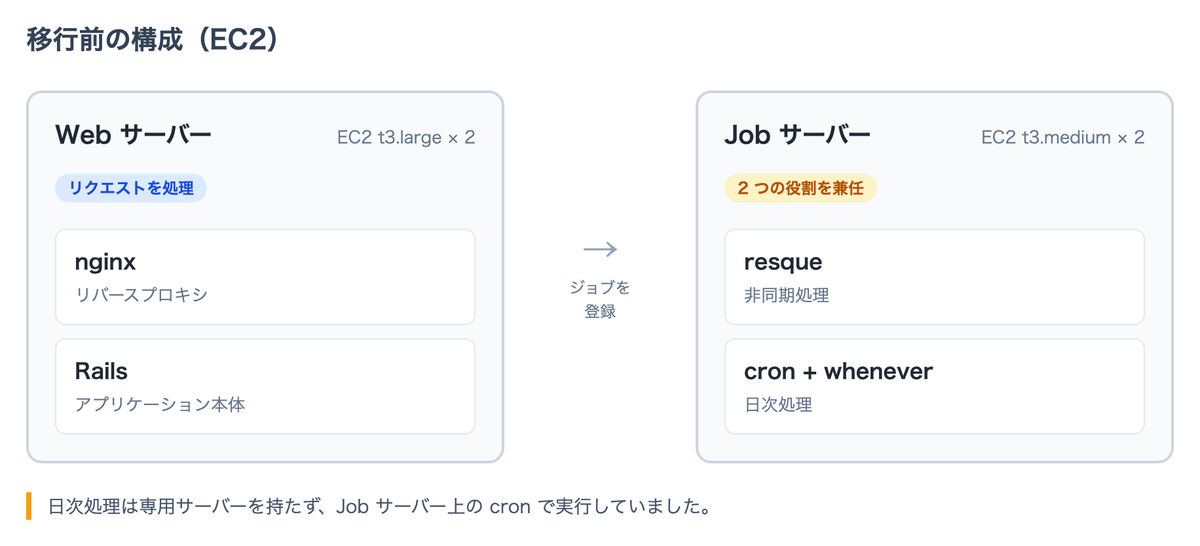
移行前のサービスは、役割ごとに2種類のEC2インスタンスで動いていました。
- Web: nginxとRailsが動くアプリケーションサーバー
- Job: resqueによる非同期処理と、cron・wheneverによる日次処理を担うサーバー
Jobサーバーが非同期処理と日次処理の両方を抱えている点が、のちの移行で関わってきます。
課題1: デプロイに時間がかかっていた
デプロイは、役割の違う2つに分かれていました。
コードのデプロイ(約10分)
アプリケーションのコードを変更したときに実行するデプロイです。すでにできあがっている箱に、新しい中身を入れ直すイメージです。
インフラのデプロイ(約30分)
Terraformのapplyと、AnsibleによるEC2の環境構築をまとめて実行するデプロイです。ミドルウェアを入れたりサーバーの設定を整えたりと、アプリケーションを動かすための箱そのものを用意するイメージです。
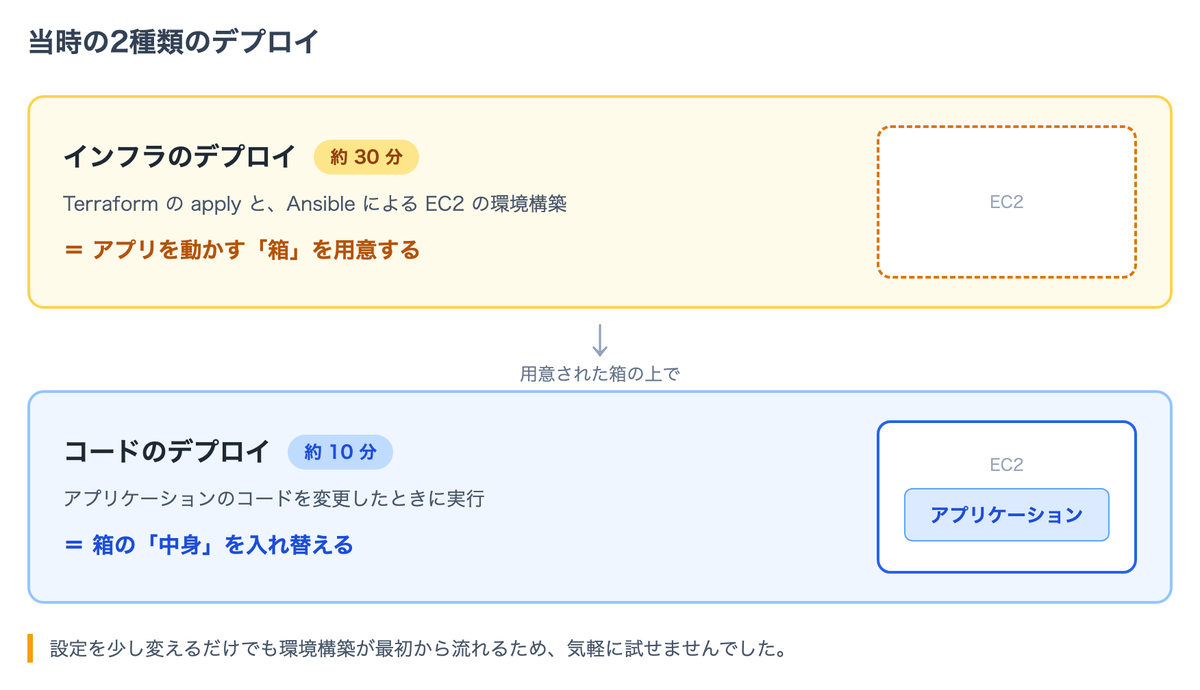
日々の開発で動かすのは、ほとんどがコードのデプロイです。それでも10分は待つことになります。そして、箱の側に手を入れるときは30分コースです。
厄介だったのは、変更の大小にかかわらず時間がほぼ変わらないことでした。設定を1行書き換えるだけでも、Ansibleは環境構築を最初から流し直します。そのため「ちょっと直して確認する」というサイクルを回すのが、とにかく億劫でした。結果として、リリース頻度が週に1回程度になりビッグバンリリースになりがちという課題がありました。
課題2: Ansible自体の保守がつらかった
デプロイの遅さに加えて、Ansibleのコードそのものを保守し続けるコストもありました。Ansibleのアップデート対応が追いついておらず、古いまま放置されているものが複数ありました。
そこでECSへの移行を決めました
これらの課題を解決する手段として選んだのが、EC2からECSへの移行です。
コンテナイメージを使ったデプロイに切り替えれば、デプロイがイメージの差し替えで済むため、デプロイスピードの向上が見込めます。また、Ansibleによるサーバー構築が不要になり、保守の対象も減らせると考えました。
実際にやったこと
本番用Dockerfileの作成
まずは、ECSの元となるDockerイメージの作成から行いました。開発環境はすでにDockerで動いていたものの、そのまま本番で使える形ではありませんでした。セキュリティ面が考慮されていなかったためです。
本番用のDockerfileを書くのは初めてだったので、まずはベストプラクティスを一から勉強するところから始めました。参考にしたのは以下の4つです。
- Building better container images(AWS Containers Blog)
- Dockerfile を書くベストプラクティス(Docker ドキュメント日本語版)
- セキュリティのベストプラクティス(Docker ドキュメント日本語版)
- Dockerイメージのセキュリティベストプラクティス10選(Snyk)
そのうえで、特に意識したのが次の2点です。
非rootユーザーで実行する
コンテナ内のプロセスをrootで動かさないようにしました。万が一コンテナに侵入された場合の影響範囲を小さくするためです。
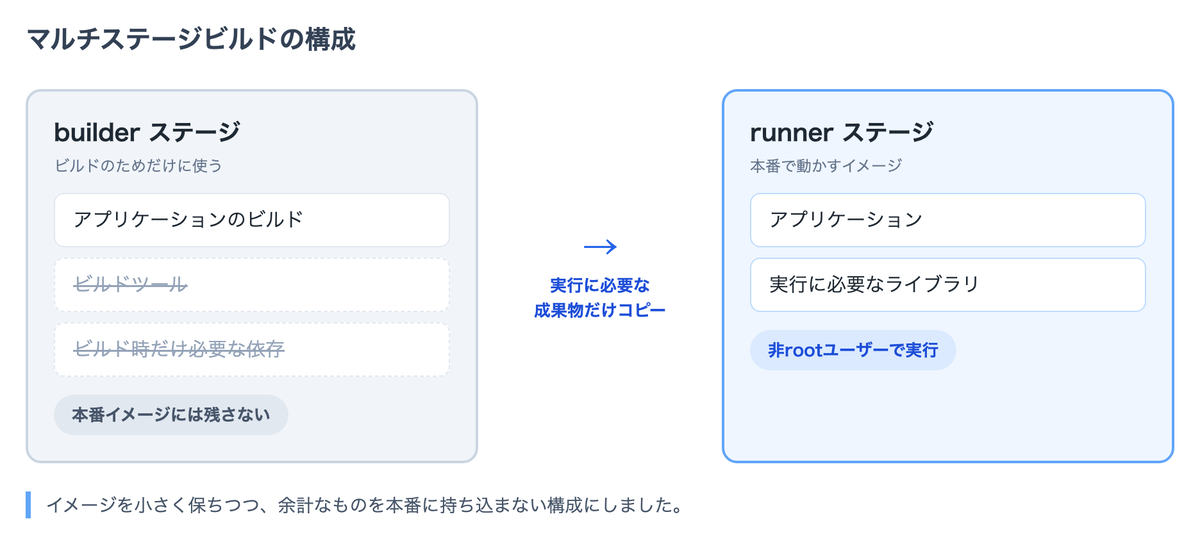
マルチステージビルドでイメージサイズを最小限にする
builderとrunnerの2段構成にして、ビルドのときだけ必要なものを本番のイメージに持ち込まないようにしました。イメージが小さくなればデプロイも速くなりますし、余計なものが入っていない分、脆弱性の混入も抑えられます。
ステージング環境で動かす
次に、作成したDockerイメージをもとに、ステージング環境のECSでアプリケーションを動かしました。イメージができたからといって、すぐにアプリケーションが起動するわけではありません。RDSやEFS、ElastiCacheとの接続。セキュリティグループやNATゲートウェイの設定。やることは山ほどありました。サービス側の理解とAWS側の理解が、どちらも求められる場面です。
そして、ここが資格の知識を一番活かせた場面でもありました。
資格の勉強では、ベストプラクティスとされる設計パターンを徹底的に叩き込まれます。新卒だと、既存の構成やコードをそのまま正しいものとして受け入れてしまいがちです。しかし資格を取ったことで、「この構成は本当に正しいのか」と立ち止まって考えられるようになりました。
具体的には、こんな疑問を持てるようになりました。
- NATゲートウェイではなく、VPCエンドポイントを使えるのではないか
- Fargate Spotは使えないのか
- IAMの権限は、もっと絞れるのではないか
サービスの特性や時間の都合もあり、今回の移行で構成を大きく変えて最適化できたわけではありません。ただ、気づいた点はIssueとして起票しているので、これから少しずつ改善していく予定です。
ログ設計
移行の中で、意外と悩んだのがログです。
EC2時代のログ
EC2では、ログをいったんファイルに書き出し、それをCloudWatchに送る形を取っていました。処理の種類ごとにファイルを分けていたので、「このログはこのファイルを見る」という切り分けができていました。
ただ、ファイルに書き出すだけで、CloudWatchまで送れていないログもありました。cronで動かしていた定期処理のログなどです。確認したいときはサーバーに入って見る、という状態になっていました。
ECSでのログ
ECSでは、コンテナが標準出力に書いた内容が、そのままCloudWatchに流れていきます。ファイルを経由しないため、送り漏れていたログもまとめて拾えるようになります。
一方で、困ったこともありました。これまでファイルで分けていたログが、すべて同じロググループに出力されることになります。そのまま移行すると、あらゆる処理のログが1か所に混ざり、どれがどの処理のログなのか分からなくなってしまいます。
そこで構造化ログを採用しました
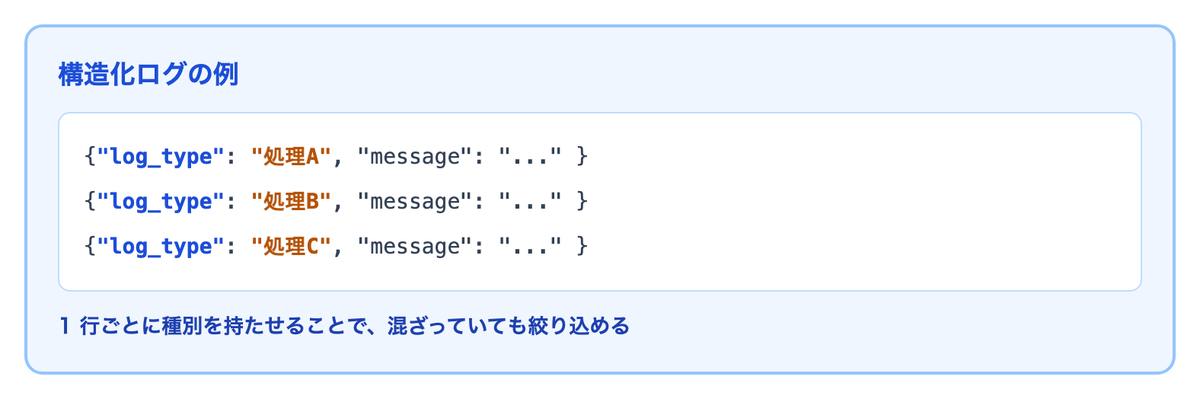
そこで、ログをJSON形式の構造化ログにする方針を取りました。1行ごとに「どの処理が出したログなのか」が分かる情報を持たせることで、あとから絞り込めるようにするためです。
負荷検証でスペックを決める
ECSは、思っていた以上にコストがかさみます。EC2時代と同じスペックをそのまま採用すると、料金が跳ね上がってしまいます。そこで、負荷検証をしたうえでスペックを決めることにしました。進め方は次の3ステップです。
- CloudWatch Logsから、リクエスト数が多いエンドポイントとレスポンスタイムが長いエンドポイントを洗い出す
- 本番と同じくらいの件数のデータを、検証環境に用意する
- k6で1秒あたりのリクエスト数を指定して投げ続け、どこまで耐えられるかを測る
※ k6 とは、スクリプトで負荷のかけ方を記述できる、オープンソースの負荷試験ツールです。
結果として、1 vCPUではCPU使用率が100%に張り付いてしまい、足りませんでした。2 vCPUにすると40%弱に収まったため、Webには2 vCPUが必要だと判断しました。
| 指標 | 1 vCPU | 2 vCPU |
|---|---|---|
| ECSのCPU使用率 | 100% | 38.5% |
Jobについては、過去のCPUとメモリ使用率を確認しました。すると、スペックを使っていたのはJobと常駐させていたcronの処理だと分かりました。そこでcronを別のタスクとして切り分けることで、Job側をスペックダウンできました。
CPUアーキテクチャには、x86ではなくARM(AWS Graviton)を選びました。x86より単価が安いことに加えて、動作検証でも問題がないと確認できたためです。
最終的なスペックは次のとおりです。
| 用途 | EC2(移行前) | Fargate ARM(移行後) |
|---|---|---|
| web | t3.large(2 vCPU / 8 GiB)× 2 | 2 vCPU / 4 GiB × 2 |
| job | t3.medium(2 vCPU / 4 GiB)× 2 | 1 vCPU / 4 GiB × 2 |
| cron | なし(jobサーバーに同居) | 2 vCPU / 4 GiB(1日数分程度) |
意識したのは、現状バイアスに引きずられないことです。EC2のスペックをそのまま持ち込むのではなく、必要な分を測ったうえで決める。当たり前のようでいて、既存の構成があると引っ張られてしまう部分だと思います。
IaCの構成を作り直す
インフラはもともとTerraformでコード化されていました。ただし、環境ごと・リソースごとにディレクトリとstateが分かれていました。01_network → 02_security_group → … と、番号順にapplyしていく運用です。
影響範囲を小さくしたいという意図があっての構成でしたが、次のような負担も生んでいました。
- リソースを追加するたびに、番号付きのディレクトリを管理しなければならない
- applyの実行順序を、人が把握しておく必要がある
- 環境全体のplanを一度に取れない
そこでECS移行を機に、ディレクトリ構成から作り直すことにしました。選んだのは、Terraformが推奨するmodule構成ではなく、ファイルを領域ごとに分けて平置きし、stateは環境ごとに1つへ統合する構成です。
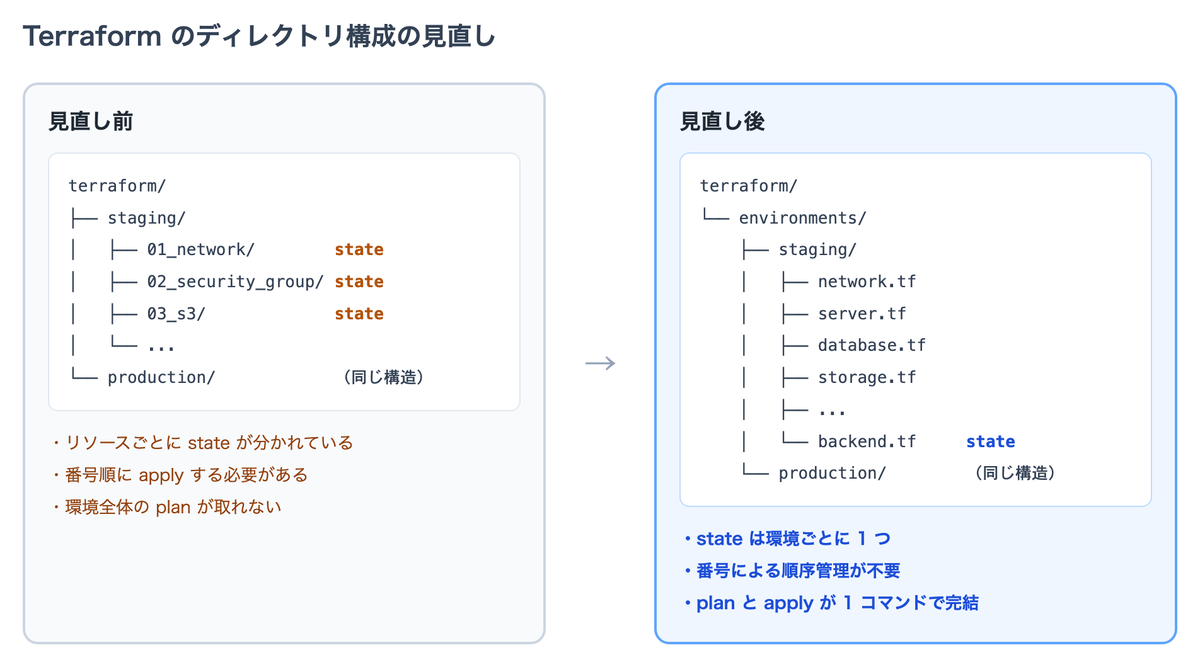
module化を見送ったのは、変更が全環境に伝播するリスクを避けたかったからです。また、複雑化したIaCをいきなりmodule化するより、まずは平置きにして、切り出せるところから徐々にmodule化していくほうが安全だと判断しました。
結果として、番号での順序管理は不要になり、環境全体のplanとapplyが1コマンドで完結するようになりました。
本番リリース
そしてついに、ドキドキの本番リリースです。
ステージング環境で動作検証を重ね、当日の手順書もガチガチに作り込んだうえで移行に臨みました。アプリケーション側のロジックはほとんど変えていないとはいえ、動く基盤がまるごと入れ替わります。
当日はメンテナンスモードに設定し、利用者の少ない夜間に実施しました。結果として、移行そのものは大きなトラブルもなく完遂できました。準備にかけた時間がそのまま結果になったと感じています。
資格の知識はどこまで通用したか
EC2からECSへの移行では、たくさんのことを経験しました。ここには書ききれなかったこともたくさんあります。その経験を振り返って、資格が効いた場所と、効かなかった場所をまとめます。
資格が効いた場所
AWSサービスの理解に時間を割かずに済んだ
知らない単語で手が止まる、ということがほとんどありませんでした。インフラのタスクは、調べ物の時間が積み重なりがちです。そこを飛ばして、設計そのものを考える時間に使えたのは大きかったと思います。
既存の構成に疑いを持てた
設計のベストプラクティスを知っているため、「この構成は本当に正しいのか」と立ち止まれました。実際のところ、AWSのサービスを使って設計していく中で、必ずベストプラクティスに則れるかというと難しいと思います。要件や期間との兼ね合いがあるからです。
それでも、要件と照らし合わせたうえで「最適な状態はこれだ」と分かっている状態と、分かっていない状態とでは、選択の幅がまったく違ってきます。
資格が効かなかった場所
コンテナまわりは、資格の範囲外だった
Dockerfileの書き方、マルチステージビルドでの依存関係の洗い出し、ライブラリの取捨選択。このあたりは資格の勉強では出てきません。公式ドキュメントを読み、手を動かしながら覚えていくしかありませんでした。
負荷検証の進め方も知らなかった
どのエンドポイントを対象にするか、どれくらいの負荷をかけるか、どの指標を見て判断するか。資格では「負荷に応じてスケールする設計」は学べますが、実際に負荷をかけて測る方法までは学べません。
移行して得られたもの
デプロイが速くなった
一番の目的だったデプロイ時間は、次のようになりました。
| デプロイの種類 | 移行前 | 移行後 |
|---|---|---|
| コードのデプロイ | 約10分 | 約8.5分 |
| インフラのデプロイ | 約30分 | 約1.3分 |
特に大きかったのがインフラのデプロイです。Ansibleでサーバーを組み立てる工程がなくなり、30分が1分ちょっとになりました。「ちょっと直して確認する」が気軽にできるようになったのは、日々の開発においてかなり助かっています。
ロールバックが速くなった
ECSへの移行にあわせて、Blue/Greenデプロイを採用しました。
新しいバージョンを別の環境に立ててから切り替える方式なので、問題があったときは切り戻すだけで元に戻せます。EC2のときのように、サーバーを作り直して前のコードを配り直す必要がありません。
コストを抑えたうえでマネージドにできた
コストの削減はできませんでした。オンデマンド料金での比較であれば微減ですが、Savings Plansを適用した状態で比べると、むしろやや上昇しています。EC2のSavings Plansに比べて、Fargateは割引率が小さいためです。
ただし、何も考えずに同じスペックを持ち込んでいたら、跳ね上がっていたはずです。負荷検証でスペックを測り、cronを切り分けて必要な分だけに絞ったことで、ほぼ横ばいに抑えられました。
ほぼ同じコストのまま、サーバーの構築や保守をAWSに任せられるようになりました。これが今回の移行で得られたものだと思っています。
今後の展望
デプロイが速くなったので、次はリリースサイクルの見直しを進めています。週に1回のビッグバンリリースから、小さく何度も出せる形へ変えていきたいと考えています。ユーザーへの価値提供を、今より速くするためです。
資格についても、次はAWS Certified Developer(DVA)を考えています。今回の移行では、CI/CDのワークフローやコンテナイメージの扱いといった、開発者寄りの領域を実務で経験しました。手を動かして覚えた部分を、あらためて体系的に学び直したいと思ったからです。
これまでは資格を取ること自体が目的でしたが、今は「もっと知りたい領域」が先にあります。そこに対してちょうどいい資格が用意されているのは、AWSのいいところだなと感じています。
まとめ
新卒1年目で取ったAWSの資格が、EC2からECSへの移行でどこまで通用したかを振り返ってきました。
効いたのは、AWSサービスの理解に時間を使わずに済んだことと、既存の構成に疑いを持てたことです。一方で、コンテナまわりや負荷検証の進め方は資格の範囲外で、手を動かしながら覚えるしかありませんでした。
振り返ってみると、資格は実務に向けた「土台づくり」と「きっかけづくり」だったのだと思います。私の場合は、資格が大きなタスクを任せてもらうきっかけになり、そのタスクを完遂するための知識の土台にもなりました。
入社したころはインフラが大の苦手だった私が、いまではインフラの改善や設計を積極的に行っています。資格で0 → 1を作り、1 → 10を実務で積み上げたからこそだと思います。
AIが台頭してきた今、新卒エンジニアにとって「何を勉強すべきか」の判断はどんどん難しくなっていると感じます。そんな中で「資格は不要」「プログラミングはもういらない」といった声に惑わされず、「AWSの資格を取ってみたい」と思えた方の背中を、この記事が少しでも押せたなら嬉しいです。
ここまで読んでいただきありがとうございました。それではまた〜
