こんにちは。技術本部でエグゼクティブテクニカルマネージャーをしている渡瀬です。
エンジニア組織を横断して、技術戦略の策定や開発環境の整備に携わっています。
その一環として、Claude Codeをはじめとした生成AIの全社活用の推進と、その安全対策を担当しています。
この記事では、Claude Codeを組織に配るときに何を統制すべきか、私たちがどう実装したかを書きます。
具体的には、managed settingsの設計とMDMによる全社配布、OpenTelemetryを使った利用ログの可視化、法務との連携体制の話です。
個人としての使いこなしTipsは扱いません。組織にAIコーディングエージェントを導入する立場の方に向けた記事です。
- 背景:AIエージェントは人の手を借りずにローカルのリソースを使う
- managed settingsの設計
- MDMによる配布
- OpenTelemetryとDatadogによる利用の可視化
- 法務との連携
- 現状と今後
背景:AIエージェントは人の手を借りずにローカルのリソースを使う
ローカルの開発環境には、認証情報やソースコードといった機密情報が集まっています。
AIコーディングエージェントは、人間の権限でこれらのファイルを読み、コマンドを実行し、ネットワークに出ていきます。
一つひとつの操作に人が確認を挟まない使い方が広がり、ローカルのリソースを扱う判断が人からツールに移りつつあります。
これにより、リスクの形が2つの面で変わりました。
1つは、悪意がなくても事故が起きるようになったことです。
エージェントが指示の解釈を誤ったり、外部のコンテンツに仕込まれた悪意ある指示を読み込んだりすれば(プロンプトインジェクション)、人が意図しない操作がその人の権限で実行されます。
もう1つは、攻撃者の道具が変わったことです。
2025年8月にはNxパッケージの汚染事件が起きました。
混入したマルウェアは、ローカルにインストール済みのAI CLI(Claude Code、Gemini CLI、Amazon Q)を認証情報の探索に利用しました。
事件全体では、2,349件の認証情報がGitHub上の公開リポジトリに流出しています。
利用者が日常的に信頼して権限を与えている実行体は、悪意ある指示にも同じ権限で応えてしまいます。
OWASPのGenAIプロジェクトも2026年Q1のレポートで、AIエージェントのリスクが理論から実世界の悪用へ移行しつつあると報告しています。
もちろん、端末上で任意のコードが動いてしまう侵害そのものへの対処は、エンドポイント対策の領域です。
そのうえで、AIエージェントの利用に固有のリスクについて、私たちが最初に満たすべきだと考えた要件は次の3つです。
- 追跡できること:誰がいつ、どのような操作をしたかを後からたどれるようにする
- 認証情報の漏洩リスクを仕組みで下げること:注意喚起に頼らず、典型的な漏洩経路を設定で塞ぐ
- AIに入れてよい情報の線引きを明確にすること
なお、私たちはClaude CodeをTeamプランで運用しています。
この記事で書く範囲の統制は、Enterprise向けの管理機能がなくても、managed settingsと自前のログ基盤で実現できます。
managed settingsの設計
Claude Codeには、利用者のローカル設定よりも優先されるmanaged settingsという仕組みがあります。
管理者が配布したmanaged-settings.jsonの内容が最優先で適用され、利用者側の設定では覆せません。
組織で統制をかける起点はここになります。
私たちがmanaged settingsで統制しているのは、次の3つです。
設定値そのものは社内の防御設定になるため、項目のレベルで紹介します。
- 危険な操作のブロック:permissionsのdenyルールで、認証情報ファイルの読み取りや危険なコマンドの実行を拒否する(要件の2つ目に対応)
- 利用ログの送信:テレメトリを有効化し、利用ログを社内の収集基盤に送る(要件の1つ目に対応。詳細は後述)
- sandboxの適用:コマンド実行をsandbox内に閉じ込める(要件の2つ目を別の層から補強)
要件の3つ目である線引きは、設定だけでは完結しないため、社内ルールの整備と後述する法務との連携で扱います。
この3つは役割が違います。
denyルールは、悪意のない操作が事故につながらないようにするガードレールです。
sandboxは、コマンド実行が及ぶ範囲をOSレベルで制限する壁です。
テレメトリは、それでもすり抜けたものを後からたどるための記録です。
1つの仕組みですべてを防ごうとせず、層を分けて受け止めるのが基本方針です。
denyに入れる基準は「取り返しのつかない事故につながるか」です。
一方で、設定を厳しくすれば操作を拒否してばかりで仕事が進まないツールになり、敬遠されてしまいます。
利用者が公式のツールから離れれば、行き着く先は会社の管理が及ばないツールや環境です。
そこで、この一線は譲らないまま、その内側でどこまで制限するかを開発部門と相談し、開発を止めない形に調整しています。
もう1つの原則は、実効性のないルールを入れないことです。
denyルールは増やすほど安全になりそうに見えます。
しかし実効性のないルールを増やしても、拒否されたエージェントが別の手段を試し始めて挙動が読みにくくなるだけで、安全性は上がりません。
denyで受けきれない領域は、sandboxとログの層で受け止めます。
統制は利用者に意識させないまま配布するものなので、余計な挙動をしないことがそのまま統制の品質になります。
MDMによる配布
managed-settings.jsonの配置先はOSごとに決まっています(公式ドキュメントを参照してください)。
このファイルをPC管理ソフト(MDM)で対象の端末に配布しています。
一度配布すれば、利用者が個別に設定しなくても、統制を適用した状態でClaude Codeを使えます。
苦労したのはWindowsとmacOSの二重管理です。
配置パスだけでなく配布の仕組みそのものがOSごとに別物なので、ポリシーを2系統維持することになります。
特に重かったのはWindows側の初期構築です。
配布パッケージを作ってMDM経由で展開する方式のため、配布に失敗すると端末側のログを調査することになりますが、この調査がなかなか大変でした。
配布の反映にも時間がかかるので、1つの不具合を直すたびに何往復も待つことになりました。
Windows標準のPowerShell 5.1がBOMなしのUTF-8スクリプトをANSIコードページとして解釈するため、スクリプト内の日本語文字列が化ける、という古典的な問題も踏みました。
設定を変更するたびに、両方で配布と適用状態を検証する必要があり、運用コストは増えます。
それでも、利用者に設定作業をさせないことを優先しました。
sandboxについても、OSごとに方式が異なるため、各環境の方式に合わせて適用しています。
OpenTelemetryとDatadogによる利用の可視化
要件の1つ目に挙げた「追跡できること」には、ログの収集基盤で応えています。
何か起きたときに、Claude Code上で誰がいつどのような操作をしていたかをたどる手掛かりを残しておくためです。
Claude CodeはOpenTelemetry形式でメトリクスとログを送信できます。
これを直接SaaSに送るのではなく、社内のOTel Collectorで一度受けてから2系統に分けています。
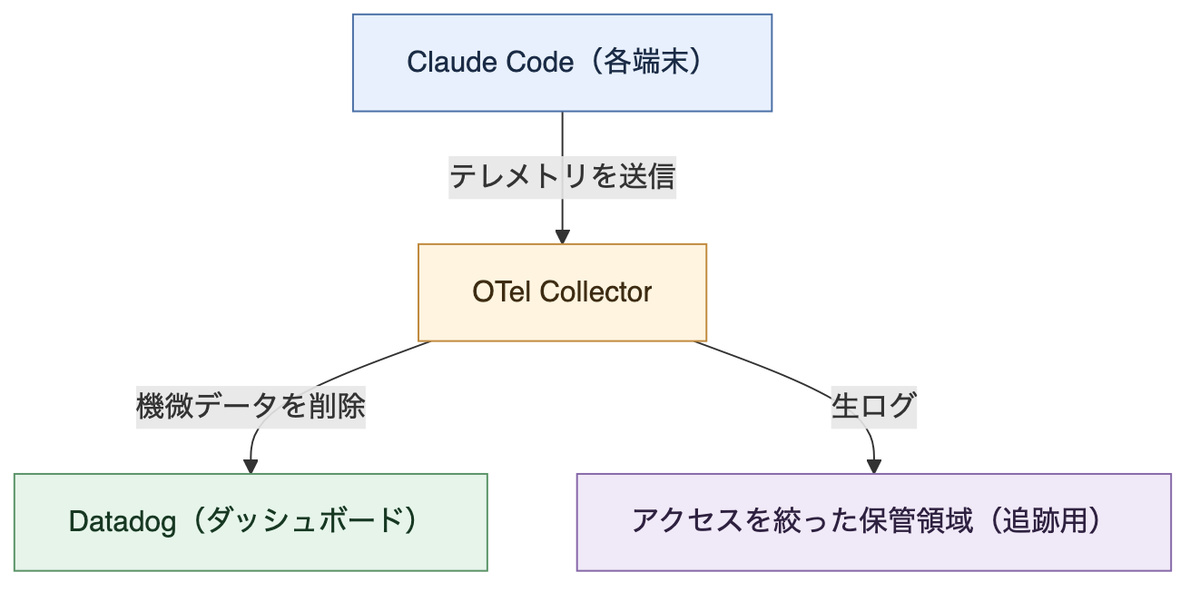
Datadogに送る側は、Collectorでプロンプト本文などの機微になりうるデータを取り除いてから流しています。
日常的に人が見るダッシュボードに、機密情報が乗らないようにするためです。
一方の生ログは、アクセスを絞った保管領域に置き、追跡という目的に限って必要になったときだけ参照できるようにしています。
「普段見る場所には機微データを置かず、追跡はできる」という分担です。
ダッシュボードの中心は、利用者数やセッション数、トークン使用量といった利用状況の指標です。
実際に見えてくると、想像とは違う事実がいくつもありました。
Premiumシート(Teamプランの上位シート)の利用者のうち9割が、シート料金以上に相当する使い方をしていました。
全体では、従量課金に換算した理論値で、定額費用の約11倍に相当する利用がありました。
もし同じ利用量を従量課金で払っていたら、定額1年分の費用を1か月あまりで使い切る計算です。
一方で利用の偏りは、いわゆる「2割の人が8割を使う」というほど極端ではなく、分布はシートの配分におおむね対応していました。
モデル別では、最上位モデルの利用が全体コストの約4割を占めることも分かりました。
利用量の実測をもとにこうした試算ができるようになり、定額プランの投資対効果やプラン選定の議論を事実ベースで行えるようになっています。
これは統制のためだけの仕組みではありません。
利用状況が見えると、使われていない領域の特定や、障壁のヒアリングにつなげられるので、利用促進の材料としても機能し始めています。
法務との連携
要件の3つ目に挙げた「AIに入れてよい情報の線引き」は、技術的な統制だけでは決められません。
個人情報の国外移転の整理、生成物や入力素材の著作権、利用規約で事業者側に渡る権利など、法的な論点が絡むからです。
そこで、新しいAIサービスの導入時には、ユースケースと利用規約、事業者の認証状況を確認して可否を判断するプロセスにしています。
その確認のなかで法的な論点が見つかったものは、法務と相談して整理します。
推進者の仕事は、技術側で結論を出すことではなく、「何が論点か」を法務が判断できる形に整理して渡すことだと考えています。
利用者全員に規約の精読を求めるのは現実的ではないので、読み込んで線引きする役割を推進側で持ち、整理した結果を社内の利用ルールとして展開しています。
現状と今後
現在は、managed settingsが対象の端末に行き渡り、利用ログがDatadogで見える状態になっています。
利用状況が見えるようになり、統制の維持や改善と並行して、活用の裾野を広げることが次の課題になりつつあります。
今後やりたいことは3つあります。
- 脅威の変化や製品側の進化に合わせて、統制の層を見直し続ける
- ダッシュボードを整備して、利用促進の議論につなげる
- 新しくAIツールを採用する際にも、同じ統制の枠組みを適用する
AIを使わないという選択肢は、もうないと考えています。
私たちが日々向き合っているのは「使うか使わないか」ではなく、「どのような形なら使ってよいか」です。
禁止すれば済むわけでも、厳しく統制すれば済むわけでもありません。
そのうえで、私たちは統制寄りに倒しています。
自動で実行される使い方では、1つの誤りが短時間に繰り返され、被害が広がりやすいからです。
ただし統制の中身は禁止ではなくガードレールで、安全に使える範囲をはっきりさせて、その中では自由に使えるようにしています。
その最初の一歩がmanaged settingsの配布です。
denyルールとログ送信の2つからでも、事故の予防と事後の追跡の足場ができます。
同じ立場でAI導入を進めている方の参考になれば幸いです。
