こんにちは、ADWAYS DEEEでデータエンジニアをしている佐藤です。
私たちのチームは、「JANet」や「AppDriver」といった自社プロダクトを支えるデータ基盤を担当しています。今回は、このデータ基盤をどう構築・運用しているかを紹介します。
データ基盤プロジェクト発足の背景
データ基盤チームとして本格的に動き始めたのは、2026年初頭からでした。
それ以前からGoogle Cloud上にデータ用プロジェクト(以下、旧データ基盤)が存在し、JANetやAppDriverのシステムデータ・トラッキングデータの分析に使われていました。しかし旧データ基盤には、次のような課題が積み重なっていました。
- 個人管理のテーブル・クエリが点在していた
- スケジュールクエリや中間テーブルが、当時の担当者が作ったまま引き継がれず残り、処理内容がブラックボックス化
- 似たようなテーブルが複数存在し、「どのテーブルを使えばいいのか分からない」状態
- 必要なデータが揃っておらず、触りにくかった
- データ基盤はエンジニアや一部のPdMしか触れておらず、営業担当が分析に使うにはハードルが高い
- どこにどんなデータがあるのか分からず説明もないため、管理画面から数字を取ってきて手元のExcelで集計する運用も残っていた
- 指標定義がばらついていた
- 同じ指標のはずなのに、部署や担当者によって数値が異なる
- BIツール上で同じKPIを見ているのに数値がずれ、「どちらが正しいのか」という問い合わせが発生(算出ロジックが一元管理されていないことが原因)
- 開発プロセスが整備されていなかった
- 通常のシステム開発のフローは整っていた一方、データパイプラインの開発フローは未整備
- バージョン管理もできていなかった
こうした課題はこれまでも分析の妨げになっていましたが、それ以上に今後の業務効率化や生成AI活用を進めていくうえで大きなボトルネックになりそうだという課題認識が、プロジェクト発足の決め手になりました。整備されていないデータの上では、AI活用も信頼できるものになりません。データを活用する人の裾野も広がりつつあるなか、誰もが安心して使えるデータ基盤が必要になっていました。
データ基盤の構成
アーキテクチャ
現在のデータ基盤のアーキテクチャは以下の図の通りです。
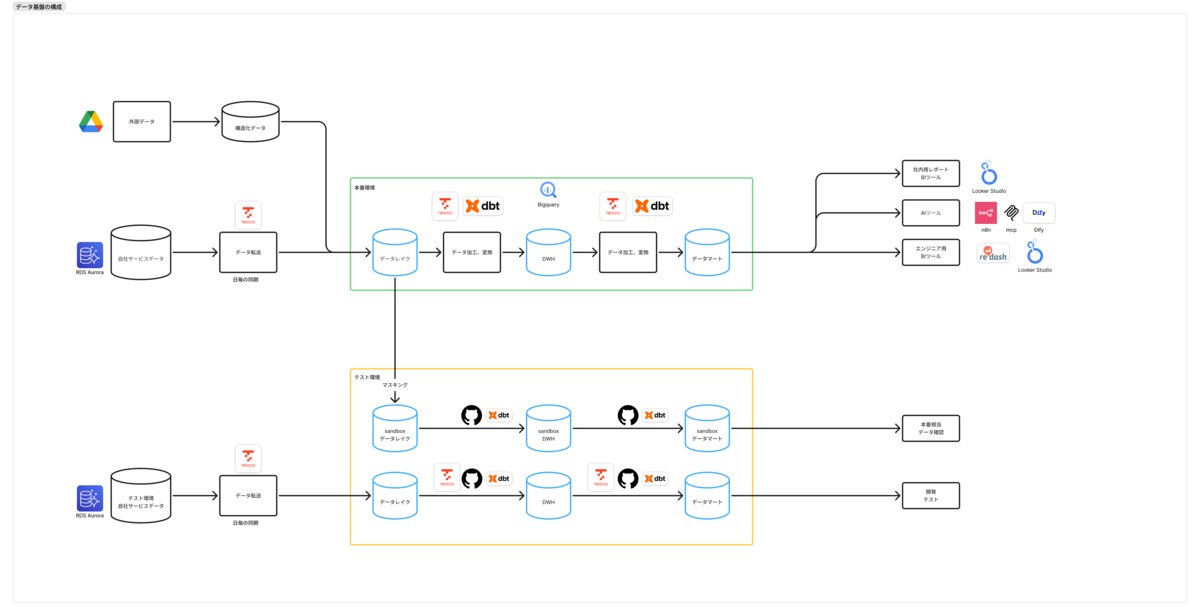
※ 図中の「Looker Studio」は現在の「Data Studio」(2026年4月に名称変更。日本語表記は「データポータル」)を指します。本記事では以降「データポータル」で表記を統一しています。
- データ取り込み:システムデータの取り込みにはTROCCOを利用しています。データ転送の設定が簡単で、かつ設定を管理しやすいことから採用しました。
- データパイプライン:dbt Coreを導入してデータパイプラインを実装しています。システムデータの取り込み後に日次で実行されるよう、TROCCO側で一連のワークフローを組んでいます。
以前はDataformを使っていましたが、次の理由から今回はdbtを採用しました。
- ネット上の情報が多く、ドキュメントが充実している
- サードパーティ製パッケージが充実している
- 連携可能なサービスが多い(今回利用しているTROCCOもdbt連携に対応)
プロジェクト構成
Google Cloudプロジェクトをデータレイク用・データウェアハウス用・データマート用に分けて管理しています。本番・テストを合わせて6プロジェクト構成です。
- プロジェクト数は多くなりますが、役割ごとにデータを管理しやすくなります
- データレイク・データウェアハウスは開発者のみアクセス可能とし、データ利用者にはデータマートのデータを使ってもらう構成にしています
データ基盤の層
dbtの層は、用途に応じて次のように役割を分けています。
| 層 | 役割 |
|---|---|
| staging | データの標準化・リネーム |
| intermediate | データクレンジング、データエンリッチメント、集計ロジックの処理 |
| marts | スタースキーマ、ワイドテーブル、BIツール用テーブルの作成 |
実際のdbtプロジェクトのディレクトリ構成は、おおまかに以下のようになっています。
dbt/
├── dbt_project.yml          # プロジェクト全体の設定
├── packages.yml             # 利用するdbtパッケージの一覧
├── profiles.yml             # 接続先の環境定義(開発 / CI / 本番 など)
├── models/                  # データ変換のSQL群(データ基盤の中心)
│   ├── staging/             # 取り込んだ生データを整形・リネームする層
│   │   ├── aaa/             #   取り込み元(ソース)ごとにディレクトリを分割
│   │   ├── bbb/
│   │   └── ccc/
│   ├── intermediate/        # 分析用に加工していく中間層
│   │   ├── adapter/         #   データのクレンジング・型の統一
│   │   └── bridge/          #   分析の主軸となるテーブル(ファクト / ディメンション)を組み立てる
│   ├── marts/               # データ利用者が実際に参照する最終層
│   │   ├── core/            #   分析の土台となるスタースキーマ
│   │   ├── summary/         #   よく使う集計をあらかじめ用意した事前集計
│   │   ├── wide/            #   複数テーブルを結合した横長の分析用テーブル
│   │   ├── reports/         #   レポート向けの集計済みデータ
│   │   └── bi/              #   BIツールから直接参照するためのデータ
│   └── sandbox/
│       └── masking/         # 個人情報などをマスキングしたデータの生成
├── snapshots/               # マスタの変更履歴を保存(過去時点の状態を再現するため)
├── macros/                  # 繰り返し使う処理を共通化(マスキング処理 など)
├── seeds/
├── tests/                   # データ品質テスト
├── analyses/
└── adr/                     # 設計判断の記録(なぜその構成にしたか)
このように、stagingはソースごと、intermediate・martsは役割・用途ごとにディレクトリを分割しています。
なお、データウェアハウス/マートの設計にはディメンショナルモデリング(スタースキーマ)を採用しており、設計にあたっては書籍『アジャイルデータモデリング』1を参考にしました。
開発プロセスの整備
旧データ基盤の課題だった「バージョン管理・開発フローの未整備」は、次のように解決しました。
以前はスケジュールクエリで主にデータ処理を管理していましたが、これをdbtでコードとして管理することでバージョン管理を実現し、通常のシステム開発と同様の開発・レビューフローに乗せられるようにしました。
- バージョン管理・レビュー:GitHubでコードをバージョン管理し、PRベースでレビューを実施
- CI/CD:GitHub Actionsで以下を自動化しています
- 開発時(PR時):
dbt buildの実行と、開発時に作成したモデルの削除(クリーンアップ) - 定期実行:
dbt source freshnessによるソースデータの鮮度チェック(日次)、sandbox用データソース(マスキング済み)の作成(週次)
- 開発時(PR時):
- データ品質テスト:dbtのテスト機能を活用
- generic data test:nullチェック、ユニークチェック、外部キーの存在チェック
- unit test:マクロや計算ロジックのテスト
また、これらの開発作業ではClaude Codeも活用しています。データプロファイリング・dbtモデル作成・レビューといった作業ごとに、専用のskillを自作して利用しています。さらに、Claude Code自体のハーネス(CLAUDE.mdやサブエージェント、フックなどの設定)も整備することで、少人数でも開発を回せるようにしています。
本番相当のデータ環境
データパイプライン開発時の課題として、開発・テスト環境のデータ量が少ないという問題がありました。そこで本番データをコピー(データ量が多いテーブルは期間を指定)し、マスキングを施した環境を用意することで、以下の確認・テストをしやすくしました。
- 本番データ特有の不整合の検出(例:本来値が入るはずのカラムにnullが入っているケース)
- 本番相当のデータ量での負荷テスト
データ利用者からのアクセス
データ利用者は、データマート層のテーブルをデータポータルから参照して分析やレポーティングを行っています。
また、非エンジニアが主に利用しているClaude Cowork(AnthropicのAIエージェントツール)からも、データ基盤を使えるようにしています。具体的には、データマートをBigQuery MCP2経由で参照できるデータとして、一部のメンバーに提供しています。これにより、SQLを書かずとも自然言語でデータ基盤のデータを分析できる環境を試験的に整えています。
工夫した点
メタデータの管理
旧データ基盤にも、サービスごとのテーブル定義書は存在していました。しかし管理方法がバラバラで更新されないことも多く、説明も足りていない状態でした。「どこにどんなデータがあるのか分からない」という背景の課題は、ここに起因していました。
そこで、テーブル/カラムの説明・リネージ・オーナー・指標定義といったメタデータを整備しました。整備は次のような手順で地道に進めました。
- まずは既存のテーブル定義書から取得
- 足りない情報は社内の情報(Notion)から補完
- それでも分からない内容はサービス担当者にヒアリングして埋める
このメタデータの拡充作業には、Claude Codeも活用しました。バラバラだったテーブル定義書やNotionの情報をdbtのYAML形式へ転記させたり、スキーマやソースコードをもとにカラム説明のドラフトを自動生成させたりすることで、整備を大きく効率化できました。
整備したメタデータには指標定義も含めています。旧データ基盤では「同じ指標でも部署や担当者で数値が異なる」という課題がありましたが、まずは算出ロジックの根拠となる定義をメタデータとして明文化することで、この解消に着手しました。指標を横断的に一元管理する仕組みそのものは、「今後」の章で触れるセマンティックレイヤー3で整えていく予定です。
整備したメタデータはdbt docsに集約し、GitHub Pages上で開発者向けに公開しています。現在はデータ利用者からも「見たい」という要望があり、社内への公開を検討しているところです。
なお、カラム説明などをYAMLで必須化まではしていませんが、ドキュメントのカバレッジを測定し、100%になるように運用しています。これにより「説明がない・更新されない」という以前の状態への逆戻りを防いでいます。
dbt snapshotによるマスタの履歴管理
システムデータのマスタは時間とともに変化しますが、分析では当時の状態のまま振り返りたいケースがあります。そこでdbt snapshotを使い、マスタの履歴を管理しています。
例えば、マスタのカテゴリ分類は時間とともに見直されることがありますが、分析では当時設定されていたカテゴリで集計したいというニーズがあります。dbt snapshotでマスタの履歴を残すことで、こうした「過去のある時点の状態を再現した分析」ができるようになりました。
今後
データ基盤の土台は整ってきましたが、まだ道半ばです。今後は次のような取り組みを進めていきます。
- セマンティックレイヤーの導入
- 背景で挙げた「指標定義のばらつき」の根本解消と、AIエージェント経由のデータ分析で算出される数値の品質担保
- AIが集計する数値の信頼性担保に向けた、指標定義そのものの一元管理
- 人が集計してもAIが集計しても同じ答えが返る状態づくり
- データガバナンス・データマネジメントの整備
- データ基盤を社内全体に展開していくため、アクセス権管理や個人情報の取り扱いに関するルールづくり
- データ品質向上のための監視・仕組みづくり
おわりに
今回は、私たちのチームで構築・運用しているデータ基盤について紹介しました。
旧データ基盤で抱えていた課題には、それぞれ次のように対応してきました。
| 旧データ基盤の課題 | 対応 |
|---|---|
| 個人管理のテーブル・クエリの点在 | dbtによるコード管理への集約 |
| データの探しにくさ・触りにくさ | メタデータの整備と、データポータルやClaude Coworkから参照できる環境づくり |
| 指標定義のばらつき | 指標定義の明文化と、今後のセマンティックレイヤー導入 |
| 開発プロセスの未整備 | GitHub・CI/CD・データ品質テストによる、通常のシステム開発と同様のフローの実現 |
最終的には、社内の誰もがデータを活用でき、データ基盤を使った分析が"当たり前"になっている状態を目指しています。そのための基盤づくりを、これからも続けていきます。
この記事が、これからデータ基盤を立ち上げるチームの参考になれば嬉しいです。
- 『アジャイルデータモデリング 組織にデータ分析を広めるためのテーブル設計ガイド』↩
- MCP(Model Context Protocol)— AIが外部のデータやツールに接続するためのオープンな標準規格。BigQuery MCPを使うと、AIからBigQueryのデータを参照できる。公式サイト↩
- セマンティックレイヤー — 指標(KPI)の算出ロジックを一元的に定義し、どのツール・経路から参照しても同じ計算結果を返すようにする層。↩
